Todo código base tiene una: una expresión regular, copiada de Stack Overflow, que «valida» direcciones de correo. Parece una comprobación, pero responde a una pregunta que casi nadie se está haciendo en realidad. Una regex puede decirte que una cadena tiene forma de dirección de correo. No puede decirte si la dirección existe, si acepta correo o si no provocará un rebote definitivo en tu próxima campaña, y eso es lo único que importa.
La respuesta corta#
Una regex valida la sintaxis, no la entregabilidad. definitely-fake@gmail.com es
una dirección de correo perfectamente válida según cualquier regex jamás escrita, y rebotará
en cuanto le envíes algo. Peor aún: las regex a las que recurre la gente o bien rechazan
direcciones reales (demasiado estrictas) o bien aceptan disparates (demasiado laxas), y la que es
técnicamente correcta ocupa cientos o miles de caracteres y aun así no puede confirmar un
buzón. Usa una comprobación de sintaxis sencilla para detectar erratas de dedo en el input y luego
verifica la entregabilidad con una comprobación de DNS y SMTP, que es un problema de red, no
de coincidencia de patrones.
La regex que has visto y lo que deja pasar#
Aquí está el arquetipo, alguna variante de esto vive en la mayoría de proyectos:
const re = /^[^@\s]+@[^@\s]+\.[^@\s]+$/;
re.test("definitely-fake@gmail.com"); // true  ← will hard-bounce
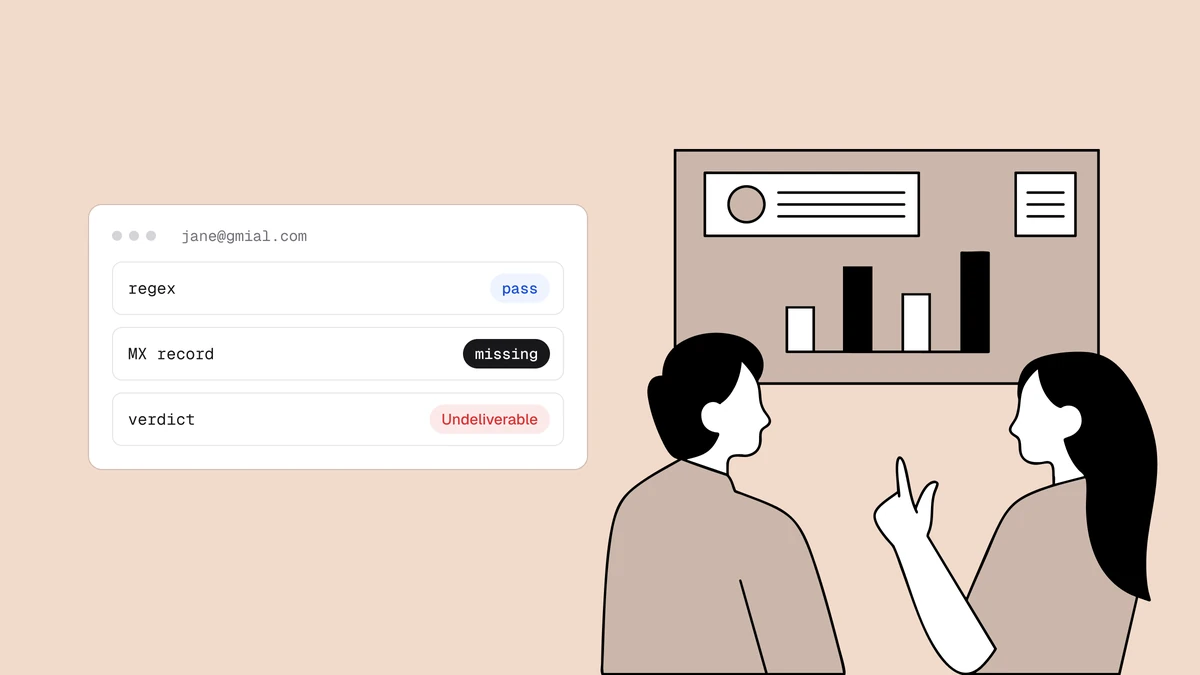
re.test("typo@gmial.com");            // true  ← typo'd domain, bounces
re.test("info@company-that-folded.com"); // true  ← dead domain
Las tres pasan. Las tres son no entregables. La regex hizo su trabajo a la perfección y no te dijo nada útil, porque la sintaxis y la entregabilidad son preguntas distintas. Cada dirección que una regex puede ver es una cadena; que haya una persona leyendo el correo detrás es un hecho sobre internet, no sobre la cadena.
Ningún patrón puede detectar un dominio mal escrito como gmial.com; eso
requiere compararlo con los proveedores conocidos. Consulta las
erratas de correo más comunes o prueba el
verificador de errores tipográficos gratuito.
Las direcciones que las regex estrictas rechazan por error#
Los patrones estrictos fallan en sentido contrario. Este patrón típico, «más ajustado», rechaza todas las direcciones válidas de la tabla siguiente:
const STRICT = /^[\w.-]+@\w+\.[a-z]{2,4}$/i;
| Dirección | Suposición falsa | Realidad |
|---|---|---|
jane+news@example.com | La parte local solo admite letras, dígitos, puntos, guiones y guiones bajos | El direccionamiento con signo más es legal; Gmail y muchos otros entregan el correo +tag en el buzón base |
o'brien@example.com | Los nombres no llevan signos de puntuación | El apóstrofo es un carácter legal en la parte local |
jane@studio.photography | Los TLD tienen de 2 a 4 letras | TLD largos como .photography llevan años activos |
jane@mail.example.co.uk | Un dominio es un nombre más un TLD | .co.uk y los subdominios de correo añaden etiquetas |
jane@my-company.com | Los dominios solo tienen letras y dígitos | Los guiones son legales dentro de una etiqueta |
Cada rechazo es una persona real que se queda fuera al registrarse, y ninguno aparece en tus logs de rebotes, por eso los patrones demasiado estrictos sobreviven durante años. La comprobación de sintaxis de más abajo acepta las cinco.
El laberinto del RFC 5322#
«Vale», dice el razonamiento, «usaré una regex correcta». La gramática formal de
una dirección de correo está definida por el RFC 5322, y una regex que realmente la implementa
es célebremente monstruosa: de cientos a miles de
caracteres, y permite cosas que nunca querrías aceptar, como partes locales
entrecomilladas con espacios ("a b"@example.com) y comentarios dentro de la dirección.
De ahí se derivan dos problemas. Primero, la regex estricta acepta más de lo que quieres, no menos: valida contra una especificación de 2008, no contra «direcciones a las que los servidores de correo reales van a entregar». Segundo, ni siquiera una coincidencia impecable con el RFC 5322 puede decirte si el dominio tiene un servidor de correo o si el buzón existe. Has invertido un esfuerzo enorme en responder a la pregunta fácil con más precisión, mientras que la pregunta difícil, ¿llegará el correo?, sigue completamente intacta.
Límites de longitud: 64, 255 y 254#
El RFC 5321, el estándar de SMTP, limita la parte local (antes de la @) a 64
octetos, el dominio a 255 y la ruta completa a 256, incluidos los corchetes
angulares que rodean la dirección (<jane@example.com>). Eso deja un techo real
de 254 caracteres para la dirección en sí.
Algunas de nuestras guías por lenguaje comprueban length <= 320 (64 + 1 + 255)
en su lugar. Es un límite laxo pero inofensivo: todo lo que rechaza es realmente
demasiado largo, y cualquier dirección de más de 254 caracteres que deje pasar
aún tiene que superar las comprobaciones de DNS y SMTP.
Las tres cosas que una regex fundamentalmente no puede hacer#
Ningún patrón, por ingenioso que sea, puede llegar al otro lado de la red. Una regex no puede:
- Comprobar que el dominio puede recibir correo.
user@company-that-folded.comtiene sintaxis válida sobre un dominio sin registros MX. Solo una consulta DNS revela el dominio muerto. - Confirmar que el buzón existe.
noreply-9f2x@gmail.comtiene sintaxis válida para una cuenta que nunca se creó. Solo una conversación SMTP con Gmail puede decirte que no está ahí. - Detectar un dominio catch-all. Un servidor catch-all acepta todas las direcciones, así que ni siquiera una comprobación SMTP en vivo puede confirmar un buzón concreto, y una regex no tiene ni idea de que el dominio se comporta así.
Estas no son carencias de una regex en particular; están fuera de lo que cualquier regex puede hacer, porque son preguntas sobre servidores, no sobre cadenas. Responderlas es trabajo de la verificación de correo, que pregunta a la red y no a la cadena.
Qué hacer de verdad: validar por capas#
La entregabilidad es una tubería de comprobaciones cada vez más costosas, y la sintaxis es solo la primera etapa, la barata (el panorama completo está en cómo funciona la verificación de correo):
- Sintaxis — una comprobación sencilla en el input para detectar erratas evidentes. Esta es la única capa a la que pertenece una regex.
- Dominio y MX — una consulta DNS para confirmar que el dominio puede recibir correo siquiera. Consulta las guías de Node.js y Python para ver código funcional.
- Sondeo SMTP del buzón — la conversación de entrega que realmente confirma el buzón, más la detección de catch-all. Esto necesita un servidor de correo con una reputación de IP limpia y una limitación de tasa cuidadosa, por lo que la mayoría de equipos recurren a una API de verificación en lugar de construirlo. Demostrar que la persona es dueña de la dirección es otro trabajo, el de un correo de opt-in doble.
La comprobación de sintaxis que vale la pena conservar#
Para la capa 1, no te fabriques a mano el RFC 5322. La jugada pragmática es el input de correo HTML5 en el navegador (que aplica gratis el patrón del estándar vivo de la WHATWG) y una comprobación corta y permisiva en el servidor:
// Pragmatic: rejects fat-finger errors, accepts the addresses real
// mail servers actually deliver to. Not a deliverability check.
const SYNTAX = /^[^\s@."]+(?:\.[^\s@."]+)*@[^\s@.]+(?:\.[^\s@.]+)+$/;

function isPlausibleEmail(email) {
  return (
    email.length <= 254 &&      // RFC 5321 path limit
    email.indexOf("@") <= 64 && // local part limit
    SYNTAX.test(email)
  );
}

isPlausibleEmail("jane@example.com");             // true
isPlausibleEmail("jane+news@mail.example.co.uk"); // true
isPlausibleEmail("not-an-email");                 // false
isPlausibleEmail("a@@b.com");                     // false
isPlausibleEmail("a..b@x.com");                   // false: consecutive dots
isPlausibleEmail(".a@x.com");                     // false: leading dot
isPlausibleEmail("a.@x.com");                     // false: trailing dot
Úsala para dar retroalimentación instantánea mientras se escribe, nada más. Trata un aprobado como «vale la pena comprobarlo en serio», nunca como «válida».
El punto queda fuera de la clase de la parte local, así que solo puede ir entre caracteres. Eso rechaza los tres errores con puntos, acepta las cinco direcciones de la tabla de regex estrictas y mantiene el patrón rápido. La comprobación del navegador es una comodidad, no una barrera: cualquiera puede enviar datos directamente a tu endpoint, así que repite la comprobación en el servidor.
ReDoS: cuando la regex de correo es la vulnerabilidad#
Un patrón mal diseñado también puede bloquear tu servicio. Los motores integrados de JavaScript y Python hacen backtracking: cuando una coincidencia falla, prueban todas las demás formas en que el patrón podría dividir la entrada. Si un grupo repetido puede coincidir con los mismos caracteres que la parte anterior, el número de divisiones crece de forma exponencial.
Versiones anteriores de esta página recomendaban esa forma,
[^\s@"]+(?:\.[^\s@"]+)*, en la que el punto encaja tanto en la clase como en
el separador del grupo. Con una cadena de a. repetidos sin @, cada punto
adicional duplicaba aproximadamente el tiempo de ejecución en nuestra propia
prueba rápida en Node, y una entrada de menos de 60 caracteres bloqueaba el
proceso durante segundos. Eso es ReDoS (CWE-1333). Si copiaste el patrón
antiguo, sustitúyelo por el de arriba.
Tres soluciones:
- Clases que no se solapan. Sacar el punto de las clases deja una sola forma de leer cualquier entrada, así que el patrón de arriba se ejecuta en tiempo lineal.
- Un motor de tiempo lineal. El paquete
regexpde Go lo garantiza, y los bindings de RE2 lo llevan a Node y Python. - Un parser en lugar de un patrón, como
net/mail.ParseAddressde Go. Mantén Go actualizado: las versiones anteriores a 1.24.8 y 1.25.2 analizan con lentitud los literales de dominio muy largos.
Limitar la longitud no te salvará: esta forma se atasca muy por debajo de los
254 caracteres. Para detectar el fallo, mide el tiempo de una cadena que no
coincida, como "a.".repeat(25) + "!": un patrón vulnerable tarda una fracción
de segundo apreciable, y uno seguro responde al instante.
Comprobaciones de sintaxis por lenguaje#
La mayoría de los stacks incluyen una comprobación de sintaxis, así que rara vez necesitas un patrón propio. Cada guía cubre las tres capas; esta tabla muestra solo la capa 1.
| Stack | Comprobación de sintaxis |
|---|---|
| Node.js | La regex de arriba |
| Express | express-validator isEmail() |
| Next.js | zod z.string().email() |
| Python | La regex de arriba |
| Django | validate_email o EmailField |
| Flask | WTForms Email() |
| PHP | filter_var() con FILTER_VALIDATE_EMAIL |
| Laravel | email:rfc,dns (sintaxis más una comprobación DNS de la ruta de correo) |
| Go | net/mail.ParseAddress |
| Java | Jakarta Mail InternetAddress |
| Spring Boot | Jakarta Bean Validation @Email |
| C# | MailAddress.TryCreate |
| ASP.NET Core | [EmailAddress] |
| Ruby | URI::MailTo::EMAIL_REGEXP |
| Rails | format con URI::MailTo::EMAIL_REGEXP |
Las funciones integradas discrepan en los casos límite, como los nombres
visibles (Jane <jane@example.com>); cada guía cubre las peculiaridades de su
stack.
Recorrer el resto del camino#
Una vez que pasa la sintaxis, la verificación de verdad es un trabajo de red. Puedes construir las capas
de DNS y SMTP tú mismo (las guías por lenguaje de arriba muestran hasta dónde puedes llegar),
pero confirmar buzones en vivo a escala tropieza con el puerto 25 bloqueado en la mayoría de
hosts, la reputación de IP y el greylisting, que es
donde una API gestionada se gana su sitio. El endpoint
POST /verify de Qualisend ejecuta toda la tubería y devuelve un veredicto
de cuatro vías (deliverable | risky | undeliverable | unknown) con un código de motivo, de modo que
tu código actúa en función de si el buzón existe y no de si la cadena tiene
una @.
Preguntas frecuentes
01¿Existe una regex correcta para validar correos electrónicos?
No en el sentido que la gente querría. Existe una regex que implementa el RFC 5322, pero ocupa cientos o miles de caracteres, acepta formas exóticas que nunca querrías admitir y aun así no puede confirmar que la dirección sea entregable. Para uso práctico, un patrón corto y permisivo (o el input HTML5 type="email") para detectar erratas es la cantidad justa de regex; lo demás es un problema de DNS y SMTP.
02¿Por qué mi regex rechaza direcciones de correo válidas?
Porque los patrones estrictos incorporan suposiciones que las direcciones reales incumplen, como dominios de nivel superior de dos a cuatro letras (.photography tiene once) o la ausencia de signos más en la parte local. Una regex demasiado estricta es una causa habitual de registros perdidos. Sé permisivo con la sintaxis y verifica la entregabilidad por separado.
03¿Cuál es la longitud máxima de una dirección de correo?
254 caracteres. El RFC 5321 limita la parte anterior a la @ a 64 caracteres y el dominio a 255, y limita la ruta SMTP completa a 256, incluidos los corchetes angulares que rodean la dirección. Si se restan esos dos corchetes, quedan 254 para la dirección en sí. Las comprobaciones que permiten hasta 320 (64 + 1 + 255) son más laxas, pero inofensivas.
04¿La validación de correo de HTML5 comprueba si la dirección es real?
No. La validación type="email" del navegador es una comprobación de sintaxis: una versión más amable y estandarizada de la misma coincidencia de patrones. Detecta arrobas @ ausentes y errores evidentes en el input, pero nunca contacta con el servidor de correo, así que no puede decirte si el dominio o el buzón existen.
05¿Qué debería usar en lugar de regex para validar correos?
Hazlo por capas: una comprobación de sintaxis permisiva para dar retroalimentación instantánea, una consulta DNS/MX para descartar dominios muertos y un sondeo SMTP del buzón para confirmar la entrega. Las dos primeras puedes construirlas tú mismo; para la capa SMTP usa una API de verificación, ya que hacerlo de forma fiable requiere reputación de IP de envío y limitación de tasa que una regex nunca podría ofrecer.
¿Quieres ver la diferencia entre «sintaxis válida» y «se entregará de verdad»?
El plan gratuito incluye 100 créditos de verificación que ejecutan la tubería
completa (sintaxis, DNS y el sondeo SMTP del buzón), así que puedes ver cómo una
dirección aprobada por regex vuelve como undeliverable.
Sin cuenta, pega typo@gmial.com en el
verificador de correo gratuito: todas las regex de esta
página la aceptan, y el verificador sugiere gmail.com. La
referencia de la API tiene ejemplos para copiar y pegar en siete lenguajes.