Toda base de código tem uma: uma expressão regular, copiada do Stack Overflow, que "valida" endereços de e-mail. Parece uma verificação, mas responde a uma pergunta que quase ninguém está realmente fazendo. Um regex consegue dizer que uma string tem o formato de um endereço de e-mail. Ele não consegue dizer se o endereço existe, se aceita mensagens ou se não vai gerar um hard bounce na sua próxima campanha — e essas são as únicas coisas que importam.
A resposta curta#
Regex valida sintaxe, não entregabilidade. definitely-fake@gmail.com é
um endereço de e-mail perfeitamente válido por qualquer regex já escrito, e ele vai gerar bounce
no instante em que você enviar para ele. Pior ainda, os regexes que as pessoas costumam usar ou rejeitam
endereços reais (rígidos demais) ou aceitam qualquer bobagem (permissivos demais), e aquele que é
tecnicamente correto ocupa centenas ou milhares de caracteres e ainda assim não consegue confirmar uma
caixa de correio. Use uma verificação de sintaxe simples para pegar erros de digitação no input e depois
verifique a entregabilidade com uma checagem de DNS e SMTP — que é um problema de rede, não
de correspondência de padrões.
O regex que você já viu, e o que ele deixa passar#
Aqui está o arquétipo — alguma variante dele vive na maioria dos projetos:
const re = /^[^@\s]+@[^@\s]+\.[^@\s]+$/;
re.test("definitely-fake@gmail.com"); // true  ← will hard-bounce
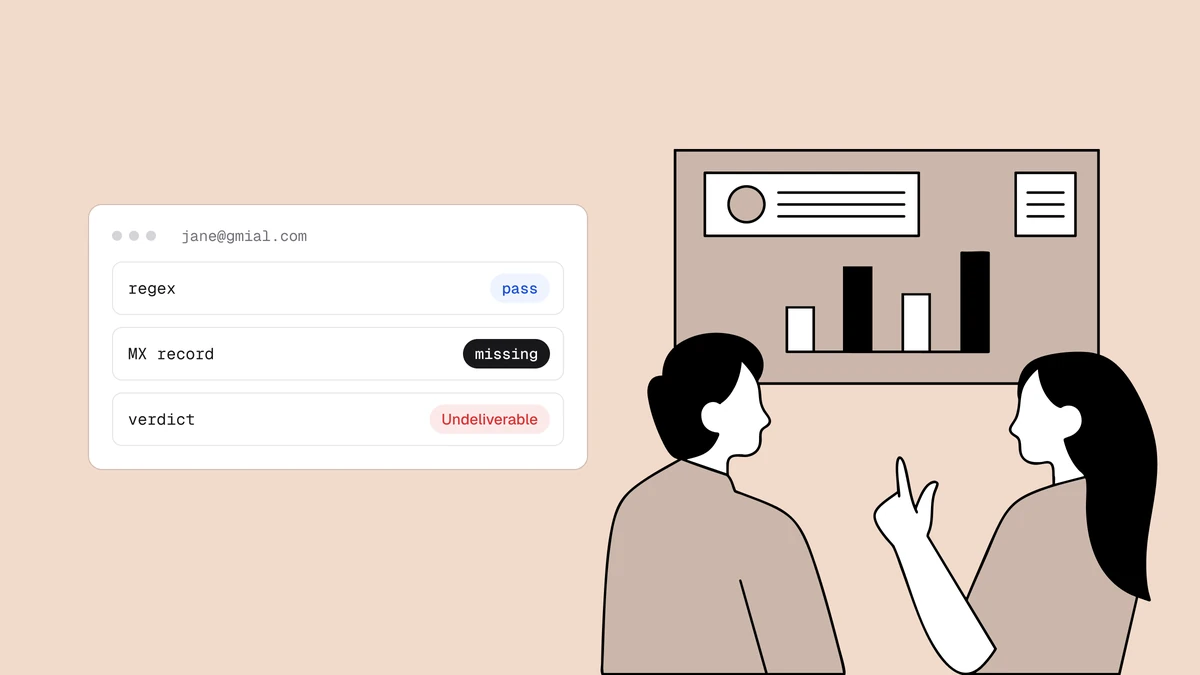
re.test("typo@gmial.com");            // true  ← typo'd domain, bounces
re.test("info@company-that-folded.com"); // true  ← dead domain
Todos os três passam. Todos os três são não entregáveis. O regex fez seu trabalho perfeitamente e não te disse nada de útil, porque sintaxe e entregabilidade são perguntas diferentes. Todo endereço que um regex consegue enxergar é uma string; se há um humano lendo mensagens nele é um fato sobre a internet, não sobre a string.
Nenhum padrão consegue pegar um domínio digitado errado como gmial.com; isso
exige uma comparação com provedores conhecidos. Veja os
erros de digitação de e-mail mais comuns ou
experimente o verificador de erros de digitação
gratuito.
Os endereços que regexes rígidos rejeitam por engano#
Padrões rígidos falham no sentido oposto. Este padrão típico, "mais apertado", rejeita todos os endereços válidos da tabela abaixo:
const STRICT = /^[\w.-]+@\w+\.[a-z]{2,4}$/i;
| Endereço | Suposição falsa | Realidade |
|---|---|---|
jane+news@example.com | A parte local só tem letras, dígitos, pontos, hifens e underscores | O endereçamento com sinal de mais é permitido; o Gmail e muitos outros entregam mensagens +tag na caixa de correio base |
o'brien@example.com | Nomes não têm pontuação | O apóstrofo é um caractere permitido na parte local |
jane@studio.photography | TLDs têm de 2 a 4 letras | TLDs longos como .photography estão no ar há anos |
jane@mail.example.co.uk | Um domínio é um nome mais um TLD | .co.uk e subdomínios de e-mail acrescentam rótulos |
jane@my-company.com | Domínios só têm letras e dígitos | Hifens são permitidos dentro de um rótulo |
Cada rejeição é uma pessoa real barrada no cadastro, e nenhuma delas aparece nos seus logs de bounce, por isso padrões rígidos demais sobrevivem por anos. A verificação de sintaxe mais abaixo aceita todos os cinco.
O labirinto da RFC 5322#
"Tudo bem", diz o raciocínio, "vou usar um regex correto." A gramática formal para
um endereço de e-mail é definida pela RFC 5322, e um regex que realmente a implementa
é notoriamente monstruoso: de centenas a milhares de
caracteres, e ele permite coisas que você nunca iria querer aceitar, como partes locais
entre aspas com espaços ("a b"@example.com) e comentários dentro do endereço.
Daí surgem dois problemas. Primeiro, o regex rígido aceita mais do que você quer, não menos — ele está validando contra uma especificação de 2008, não contra "endereços para os quais servidores de e-mail reais vão de fato entregar". Segundo, mesmo uma correspondência RFC 5322 impecável ainda não consegue dizer se o domínio tem um servidor de e-mail ou se a caixa de correio existe. Você gastou um esforço enorme para responder à pergunta fácil com mais precisão, enquanto a pergunta difícil — a mensagem vai chegar? — continua completamente intocada.
Limites de tamanho: 64, 255 e 254#
A RFC 5321, o padrão SMTP, limita a parte local (antes do @) a 64 octetos, o
domínio a 255 e o caminho inteiro a 256, incluindo os sinais de menor e maior
em volta do endereço (<jane@example.com>). Isso deixa um teto real de 254
caracteres para o endereço em si.
Alguns dos nossos guias por linguagem verificam length <= 320 (64 + 1 + 255)
em vez disso. É folgado, mas inofensivo: tudo o que essa checagem rejeita é de
fato longo demais, e qualquer endereço acima de 254 caracteres que ela deixe
passar ainda precisa superar as verificações de DNS e SMTP.
As três coisas que o regex fundamentalmente não consegue fazer#
Nenhum padrão, por mais engenhoso que seja, consegue atravessar a rede. O regex não consegue:
- Verificar se o domínio pode receber mensagens.
user@company-that-folded.comtem sintaxe válida em um domínio sem registros MX. Só uma consulta DNS revela o domínio morto. - Confirmar se a caixa de correio existe.
noreply-9f2x@gmail.comtem sintaxe válida para uma conta que nunca foi criada. Só uma conversa SMTP com o Gmail pode te dizer que ela não está lá. - Detectar um domínio catch-all. Um servidor catch-all aceita todos os endereços, então nem mesmo uma checagem SMTP ao vivo consegue confirmar uma caixa de correio específica — e um regex não faz a menor ideia de que o domínio se comporta assim.
Essas não são lacunas de um regex específico; elas estão fora do que qualquer regex consegue fazer, porque são perguntas sobre servidores, não sobre strings. Respondê-las é trabalho da verificação de e-mail, que consulta a rede, não a string.
O que fazer de fato: validar em camadas#
A entregabilidade é uma sequência de verificações cada vez mais caras, e a sintaxe é apenas o primeiro estágio barato (o quadro completo está em como funciona a verificação de e-mail):
- Sintaxe — uma verificação simples no input para pegar erros de digitação óbvios. Essa é a única camada à qual o regex pertence.
- Domínio e MX — uma consulta DNS para confirmar se o domínio pode receber mensagens em algum grau. Veja os guias de Node.js e Python para código funcional.
- Sondagem SMTP da caixa de correio — a conversa de entrega que de fato confirma a caixa de correio, além da detecção de catch-all. Isso exige um servidor de e-mail com uma reputação de IP limpa e uma limitação de taxa cuidadosa, e é por isso que a maioria das equipes recorre a uma API de verificação em vez de construí-la. Provar que a pessoa é dona do endereço é outro trabalho, o de um e-mail de double opt-in.
A verificação de sintaxe que vale a pena manter#
Para a camada 1, não escreva a RFC 5322 na mão. O caminho pragmático é o input de e-mail HTML5 no navegador (que aplica o padrão do WHATWG living standard de graça) e uma verificação curta e permissiva no servidor:
// Pragmatic: rejects fat-finger errors, accepts the addresses real
// mail servers actually deliver to. Not a deliverability check.
const SYNTAX = /^[^\s@."]+(?:\.[^\s@."]+)*@[^\s@.]+(?:\.[^\s@.]+)+$/;

function isPlausibleEmail(email) {
  return (
    email.length <= 254 &&      // RFC 5321 path limit
    email.indexOf("@") <= 64 && // local part limit
    SYNTAX.test(email)
  );
}

isPlausibleEmail("jane@example.com");             // true
isPlausibleEmail("jane+news@mail.example.co.uk"); // true
isPlausibleEmail("not-an-email");                 // false
isPlausibleEmail("a@@b.com");                     // false
isPlausibleEmail("a..b@x.com");                   // false: consecutive dots
isPlausibleEmail(".a@x.com");                     // false: leading dot
isPlausibleEmail("a.@x.com");                     // false: trailing dot
Use-a para dar feedback instantâneo no teclado — nada além disso. Trate um resultado positivo como "vale a pena verificar direito", nunca como "válido".
O ponto fica fora da classe da parte local, então só pode aparecer entre caracteres. Isso rejeita os três erros com pontos, aceita os cinco endereços da tabela de regexes rígidos e mantém o padrão rápido. A verificação do navegador é uma conveniência, não uma barreira: qualquer pessoa pode enviar dados direto para o seu endpoint, então repita a verificação no servidor.
ReDoS: quando o regex de e-mail é a vulnerabilidade#
Um padrão mal construído também pode travar o seu serviço. Os motores nativos de JavaScript e Python fazem backtracking: quando uma correspondência falha, eles tentam todas as outras formas de o padrão dividir a entrada. Se um grupo repetido consegue casar com os mesmos caracteres que a parte anterior, o número de divisões cresce exponencialmente.
Versões anteriores desta página recomendavam esse formato,
[^\s@"]+(?:\.[^\s@"]+)*, em que o ponto cabe tanto na classe quanto no
separador do grupo. Em uma string de a. repetidos sem @, cada ponto a mais
praticamente dobrava o tempo de execução no nosso próprio teste rápido em Node,
e uma entrada com menos de 60 caracteres travava o processo por segundos. Isso é
ReDoS (CWE-1333). Se você copiou o padrão antigo, troque-o pelo padrão acima.
Três correções:
- Classes que não se sobrepõem. Com o ponto fora das classes, só existe uma forma de ler qualquer entrada, então o padrão acima roda em tempo linear.
- Um motor de tempo linear. O pacote
regexpdo Go garante isso, e bindings de RE2 levam o mesmo para Node e Python. - Um parser em vez de um padrão, como o
net/mail.ParseAddressdo Go. Mantenha o Go atualizado: versões anteriores a 1.24.8 e 1.25.2 processam devagar literais de domínio muito longos.
Limitar o tamanho não vai te salvar: esse formato trava bem abaixo de 254
caracteres. Para testar a falha, meça o tempo de uma string que não casa, como
"a.".repeat(25) + "!": um padrão vulnerável leva uma fração de segundo
perceptível, e um seguro responde na hora.
Verificações de sintaxe por linguagem#
A maioria das stacks já traz uma verificação de sintaxe, então você raramente precisa de um padrão próprio. Cada guia cobre as três camadas; esta tabela mostra só a camada 1.
| Stack | Verificação de sintaxe |
|---|---|
| Node.js | O regex acima |
| Express | express-validator isEmail() |
| Next.js | zod z.string().email() |
| Python | O regex acima |
| Django | validate_email ou EmailField |
| Flask | WTForms Email() |
| PHP | filter_var() com FILTER_VALIDATE_EMAIL |
| Laravel | email:rfc,dns (sintaxe mais uma checagem de DNS da rota de e-mail) |
| Go | net/mail.ParseAddress |
| Java | Jakarta Mail InternetAddress |
| Spring Boot | Jakarta Bean Validation @Email |
| C# | MailAddress.TryCreate |
| ASP.NET Core | [EmailAddress] |
| Ruby | URI::MailTo::EMAIL_REGEXP |
| Rails | format com URI::MailTo::EMAIL_REGEXP |
As funções nativas divergem nos casos extremos, como nomes de exibição
(Jane <jane@example.com>); cada guia cobre as particularidades da sua stack.
Percorrendo o resto do caminho#
Depois que a sintaxe passa, a verificação de verdade é um trabalho de rede. Você pode construir as camadas de DNS
e SMTP você mesmo — os guias por linguagem acima mostram até onde dá para chegar —
mas confirmar caixas de correio ao vivo em escala esbarra na porta 25 estar bloqueada na maioria dos
provedores, na reputação de IP e no greylisting, que é
onde uma API gerenciada mostra seu valor. O
POST /verify da Qualisend executa toda a sequência e retorna um veredito
de quatro vias (deliverable | risky | undeliverable | unknown) com um código de motivo, para que
seu código aja com base em se a caixa de correio existe, e não em se a string tem
um @.
Perguntas frequentes
01Existe um regex correto para validação de e-mail?
Não no sentido que as pessoas gostariam. Existe um regex que implementa a RFC 5322, mas ele ocupa centenas ou milhares de caracteres, aceita formas exóticas que você nunca iria querer e ainda assim não consegue confirmar se o endereço é entregável. Para uso prático, um padrão curto e permissivo (ou o input HTML5 type="email") para pegar erros de digitação é a quantidade certa de regex - o resto é um problema de DNS e SMTP.
02Por que meu regex rejeita endereços de e-mail válidos?
Porque padrões rígidos embutem suposições que endereços reais quebram, como domínios de topo de duas a quatro letras (.photography tem onze) ou a ausência de sinais de mais na parte local. Um regex rígido demais é uma fonte comum de cadastros perdidos. Seja permissivo na sintaxe e verifique a entregabilidade separadamente.
03Qual é o tamanho máximo de um endereço de e-mail?
254 caracteres. A RFC 5321 limita a parte antes do @ a 64 caracteres e o domínio a 255, e limita o caminho SMTP inteiro a 256, incluindo os sinais de menor e maior em volta do endereço. Tirando esses dois sinais, sobram 254 para o endereço em si. Checagens que aceitam até 320 (64 + 1 + 255) são mais folgadas, mas inofensivas.
04A validação de e-mail do HTML5 verifica se o endereço é real?
Não. A validação type="email" do navegador é uma verificação de sintaxe - uma versão mais amigável e padronizada da mesma correspondência de padrões. Ela pega sinais de @ faltando e defeitos óbvios no input, mas nunca entra em contato com o servidor de e-mail, então não consegue dizer se o domínio ou a caixa de correio existe.
05O que eu deveria usar no lugar do regex para validar e-mails?
Faça em camadas: uma verificação de sintaxe permissiva para feedback instantâneo, uma consulta DNS/MX para descartar domínios mortos e uma sondagem SMTP da caixa de correio para confirmar a entrega. Construa as duas primeiras você mesmo; use uma API de verificação para a camada SMTP, já que fazer isso de forma confiável exige reputação de IP de envio e limitação de taxa que um regex jamais poderia oferecer.
Quer ver a diferença entre "sintaxe válida" e "vai de fato entregar"?
O plano gratuito inclui 100 créditos de verificação que executam a sequência
completa — sintaxe, DNS e a sondagem SMTP da caixa de correio — para que você possa ver um
endereço aprovado pelo regex voltar como undeliverable.
Sem conta, cole typo@gmial.com no
verificador de e-mail gratuito: todos os regexes desta
página aceitam o endereço, e o verificador sugere gmail.com. A
referência da API tem exemplos de copiar e colar em sete linguagens.