Chaque base de code en possède une : une expression régulière, copiée depuis Stack Overflow, qui « valide » les adresses e-mail. Elle a l'air d'un contrôle, mais elle répond à une question que presque personne ne pose vraiment. Une regex peut vous dire qu'une chaîne a la forme d'une adresse e-mail. Elle ne peut pas vous dire que l'adresse existe, qu'elle accepte le courrier, ou qu'elle ne provoquera pas de rebond dur lors de votre prochaine campagne — et ce sont là les seules choses qui comptent.
La réponse en bref#
Une regex valide la syntaxe, pas la délivrabilité. definitely-fake@gmail.com
est une adresse e-mail parfaitement valide selon toutes les regex jamais écrites,
et elle rebondira à l'instant où vous lui enverrez un message. Pire, les regex
vers lesquelles les gens se tournent, soit rejettent de vraies adresses (trop
strictes), soit acceptent des absurdités (trop laxistes), et celle qui est
techniquement correcte compte des centaines, voire des milliers de caractères et
ne peut toujours pas
confirmer l'existence d'une boîte aux lettres. Utilisez un simple contrôle de
syntaxe pour attraper les fautes de frappe au niveau du champ, puis vérifiez la
délivrabilité avec un contrôle DNS et SMTP — car c'est un problème de réseau, pas
de recherche de motif.
La regex que vous avez déjà vue, et ce qu'elle laisse passer#
Voici l'archétype — une variante de celle-ci vit dans la plupart des projets :
const re = /^[^@\s]+@[^@\s]+\.[^@\s]+$/;
re.test("definitely-fake@gmail.com"); // true  ← will hard-bounce
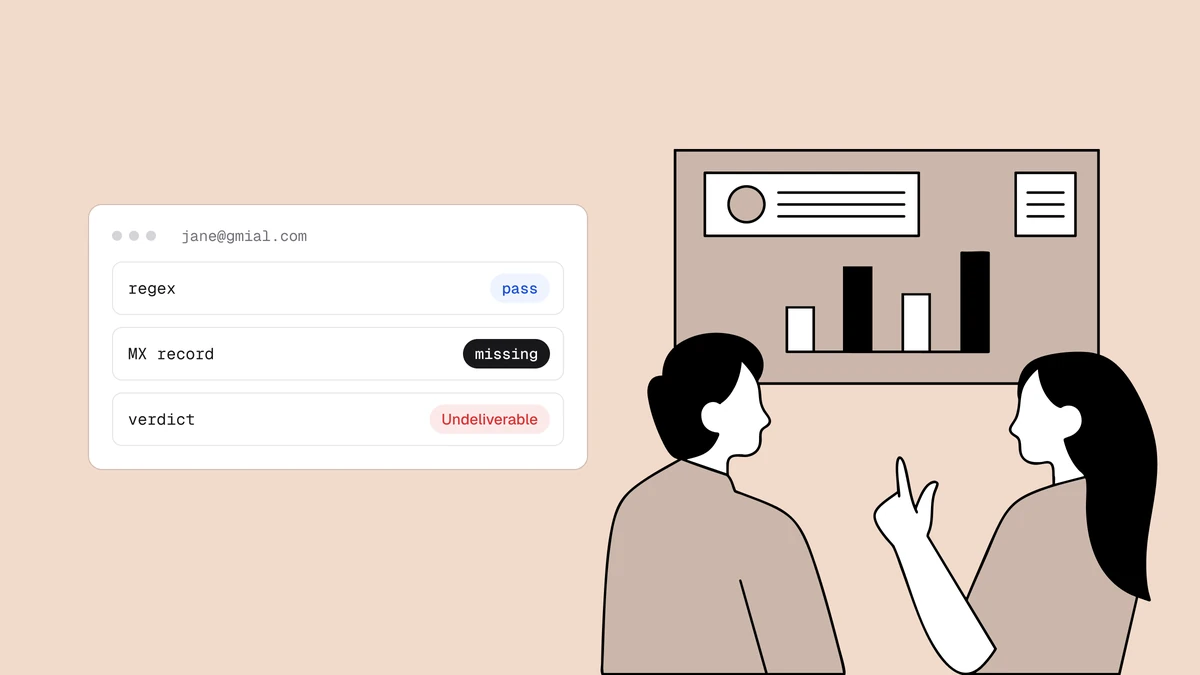
re.test("typo@gmial.com");            // true  ← typo'd domain, bounces
re.test("info@company-that-folded.com"); // true  ← dead domain
Les trois passent. Les trois sont non délivrables. La regex a parfaitement fait son travail et ne vous a rien appris d'utile, parce que syntaxe et délivrabilité sont deux questions différentes. Toute adresse qu'une regex peut voir est une chaîne ; qu'un humain y lise son courrier est un fait à propos d'Internet, pas à propos de la chaîne.
Aucun motif ne peut repérer un domaine mal saisi comme gmial.com ; il faut
pour cela le comparer aux fournisseurs connus. Consultez les
fautes de frappe les plus courantes dans les e-mails,
ou essayez le vérificateur de fautes de frappe
gratuit.
Les adresses que les regex strictes rejettent à tort#
Les motifs stricts échouent dans l'autre sens. Ce motif « plus serré » typique rejette toutes les adresses valides du tableau ci-dessous :
const STRICT = /^[\w.-]+@\w+\.[a-z]{2,4}$/i;
| Adresse | Hypothèse erronée | Réalité |
|---|---|---|
jane+news@example.com | La partie locale ne contient que des lettres, des chiffres, des points, des tirets et des tirets bas | L'adressage avec un plus est autorisé ; Gmail et bien d'autres livrent le courrier +tag dans la boîte de base |
o'brien@example.com | Les noms ne contiennent aucune ponctuation | L'apostrophe est un caractère autorisé dans la partie locale |
jane@studio.photography | Les TLD font 2 à 4 lettres | Des TLD longs comme .photography sont en service depuis des années |
jane@mail.example.co.uk | Un domaine, c'est un nom plus un TLD | .co.uk et les sous-domaines de messagerie ajoutent des labels |
jane@my-company.com | Les domaines ne contiennent que des lettres et des chiffres | Les tirets sont autorisés à l'intérieur d'un label |
Chaque rejet, c'est une vraie personne refoulée à l'inscription, et aucun n'apparaît dans vos journaux de rebonds : voilà pourquoi les motifs trop stricts survivent pendant des années. Le contrôle de syntaxe plus bas accepte les cinq.
L'engrenage de la RFC 5322#
« Très bien, se dit-on, je vais utiliser une regex correcte. » La grammaire
formelle d'une adresse e-mail est définie par la RFC 5322,
et une regex qui l'implémente réellement est tristement monstrueuse : des
centaines, voire des milliers de caractères, et elle autorise des choses dont
vous ne voudriez jamais, comme des parties locales entre guillemets contenant des espaces
("a b"@example.com) et des commentaires à l'intérieur de l'adresse.
Deux problèmes en découlent. D'abord, la regex stricte accepte plus que ce que vous voulez, pas moins — elle valide au regard d'une spécification de 2008, pas au regard des « adresses auxquelles de vrais serveurs de messagerie livreront ». Ensuite, même une correspondance RFC 5322 impeccable ne peut toujours pas vous dire si le domaine dispose d'un serveur de messagerie ou si la boîte aux lettres existe. Vous avez déployé des efforts considérables pour répondre à la question facile avec plus de précision, tandis que la question difficile — le courrier arrivera-t-il ? — reste totalement intacte.
Limites de longueur : 64, 255 et 254#
La RFC 5321, la norme SMTP, plafonne la partie locale (avant le @) à 64
octets, le domaine à 255 et le chemin complet à 256, chevrons autour de
l'adresse compris (<jane@example.com>). Il reste donc un plafond réel de
254 caractères pour l'adresse elle-même.
Certains de nos guides par langage vérifient plutôt length <= 320 (64 + 1 +
255). C'est large mais sans danger : tout ce que ce contrôle rejette est
réellement trop long, et toute adresse de plus de 254 caractères qu'il laisse
passer doit encore franchir les contrôles DNS et SMTP.
Les trois choses qu'une regex ne peut fondamentalement pas faire#
Aucun motif, si astucieux soit-il, ne peut traverser le réseau. Une regex ne peut pas :
- Vérifier que le domaine peut recevoir du courrier.
user@company-that-folded.comest une syntaxe valide sur un domaine sans enregistrement MX. Seule une résolution DNS révèle le domaine mort. - Confirmer que la boîte aux lettres existe.
noreply-9f2x@gmail.comest une syntaxe valide pour un compte qui n'a jamais été créé. Seule une conversation SMTP avec Gmail peut vous dire qu'il n'existe pas. - Détecter un domaine catch-all. Un serveur catch-all accepte toutes les adresses, si bien que même un contrôle SMTP en direct ne peut pas confirmer une boîte aux lettres précise — et une regex n'a aucune idée que le domaine se comporte ainsi.
Ce ne sont pas des lacunes d'une regex particulière ; elles sont hors de ce que toute regex peut faire, parce que ce sont des questions à propos de serveurs, pas de chaînes. Y répondre est le rôle de la vérification d'e-mails, qui interroge le réseau plutôt que la chaîne.
Ce qu'il faut vraiment faire : valider par couches#
La délivrabilité est un enchaînement de contrôles de plus en plus coûteux, et la syntaxe n'est que la première étape, la moins chère (le tableau complet est dans comment fonctionne la vérification d'e-mails) :
- Syntaxe — un simple contrôle au niveau du champ pour attraper les fautes de frappe évidentes. C'est la seule couche à laquelle une regex appartienne.
- Domaine et MX — une résolution DNS pour confirmer que le domaine peut, tout simplement, recevoir du courrier. Voir les guides Node.js et Python pour du code fonctionnel.
- Sonde SMTP de la boîte aux lettres — la conversation de livraison qui confirme réellement la boîte aux lettres, plus la détection des catch-all. Cela requiert un serveur de messagerie doté d'une réputation d'IP propre et d'une limitation de débit soignée, ce qui explique pourquoi la plupart des équipes se tournent vers une API de vérification plutôt que de la construire. Prouver que la personne possède l'adresse est une autre affaire, celle d'un e-mail de double opt-in.
Le contrôle de syntaxe qui vaut la peine d'être conservé#
Pour la couche 1, ne bricolez pas votre propre RFC 5322. La démarche pragmatique, c'est le champ e-mail HTML5 dans le navigateur (qui applique gratuitement le motif du standard vivant du WHATWG) et un contrôle court et permissif côté serveur :
// Pragmatic: rejects fat-finger errors, accepts the addresses real
// mail servers actually deliver to. Not a deliverability check.
const SYNTAX = /^[^\s@."]+(?:\.[^\s@."]+)*@[^\s@.]+(?:\.[^\s@.]+)+$/;

function isPlausibleEmail(email) {
  return (
    email.length <= 254 &&      // RFC 5321 path limit
    email.indexOf("@") <= 64 && // local part limit
    SYNTAX.test(email)
  );
}

isPlausibleEmail("jane@example.com");             // true
isPlausibleEmail("jane+news@mail.example.co.uk"); // true
isPlausibleEmail("not-an-email");                 // false
isPlausibleEmail("a@@b.com");                     // false
isPlausibleEmail("a..b@x.com");                   // false: consecutive dots
isPlausibleEmail(".a@x.com");                     // false: leading dot
isPlausibleEmail("a.@x.com");                     // false: trailing dot
Servez-vous-en pour donner un retour instantané au clavier — rien de plus. Traitez un succès comme un « à vérifier correctement », jamais comme un « valide ».
Le point est exclu de la classe de la partie locale, il ne peut donc se trouver qu'entre deux caractères. Le motif rejette ainsi les trois erreurs de points, accepte les cinq adresses du tableau des regex strictes et reste rapide. Le contrôle du navigateur est un confort, pas un verrou : n'importe qui peut envoyer des données directement à votre endpoint, alors répétez le contrôle côté serveur.
ReDoS : quand la regex d'e-mail devient la vulnérabilité#
Un motif mal construit peut aussi bloquer votre service. Les moteurs intégrés de JavaScript et de Python font du backtracking : quand une correspondance échoue, ils essaient toutes les autres façons dont le motif pourrait découper l'entrée. Si un groupe répété peut correspondre aux mêmes caractères que la partie qui le précède, le nombre de découpages croît de façon exponentielle.
Des versions antérieures de cette page recommandaient cette forme,
[^\s@"]+(?:\.[^\s@"]+)*, où le point correspond à la fois à la classe et au
séparateur du groupe. Sur une chaîne de a. répétés sans @, chaque point
supplémentaire doublait à peu près le temps d'exécution lors de notre propre
test rapide sous Node, et une entrée de moins de 60 caractères bloquait le
processus pendant plusieurs secondes. C'est du ReDoS (CWE-1333). Si vous avez
copié l'ancien motif, remplacez-le par celui ci-dessus.
Trois parades :
- Des classes qui ne se chevauchent pas. Exclure le point des classes ne laisse qu'une seule lecture possible de chaque entrée, si bien que le motif ci-dessus s'exécute en temps linéaire.
- Un moteur en temps linéaire. Le paquet
regexpde Go le garantit, et des bindings RE2 l'apportent à Node et à Python. - Un parseur plutôt qu'un motif, comme
net/mail.ParseAddressde Go. Gardez Go à jour : les versions antérieures à 1.24.8 et 1.25.2 analysent lentement les littéraux de domaine très longs.
Plafonner la longueur ne vous sauvera pas : cette forme se bloque bien en
dessous de 254 caractères. Pour détecter le défaut, chronométrez une chaîne qui
ne correspond pas, comme "a.".repeat(25) + "!" : un motif vulnérable met une
fraction de seconde perceptible, un motif sûr répond instantanément.
Contrôles de syntaxe par langage#
La plupart des stacks fournissent un contrôle de syntaxe, vous avez donc rarement besoin de votre propre motif. Chaque guide couvre les trois couches ; ce tableau ne concerne que la couche 1.
| Stack | Contrôle de syntaxe |
|---|---|
| Node.js | La regex ci-dessus |
| Express | express-validator isEmail() |
| Next.js | zod z.string().email() |
| Python | La regex ci-dessus |
| Django | validate_email ou EmailField |
| Flask | WTForms Email() |
| PHP | filter_var() avec FILTER_VALIDATE_EMAIL |
| Laravel | email:rfc,dns (syntaxe plus un contrôle DNS de la route de courrier) |
| Go | net/mail.ParseAddress |
| Java | Jakarta Mail InternetAddress |
| Spring Boot | Jakarta Bean Validation @Email |
| C# | MailAddress.TryCreate |
| ASP.NET Core | [EmailAddress] |
| Ruby | URI::MailTo::EMAIL_REGEXP |
| Rails | format avec URI::MailTo::EMAIL_REGEXP |
Les fonctions intégrées divergent sur les cas limites, comme les noms
d'affichage (Jane <jane@example.com>) ; chaque guide traite des particularités
de sa stack.
Parcourir le reste du chemin#
Une fois la syntaxe validée, la véritable vérification est un travail de réseau.
Vous pouvez construire vous-même les couches DNS et SMTP — les guides par langage
ci-dessus montrent jusqu'où vous pouvez aller — mais confirmer des boîtes aux
lettres actives à grande échelle se heurte au port 25 bloqué sur la plupart des
hébergeurs, à la réputation d'IP et au greylisting,
là où une API managée prend tout son sens. Le point de terminaison
POST /verify de Qualisend exécute tout l'enchaînement et renvoie
un verdict à quatre issues (deliverable | risky | undeliverable | unknown)
assorti d'un code de motif, pour que votre code réagisse selon que la boîte aux
lettres existe, et non selon que la chaîne contient un @.
Foire aux questions
01Existe-t-il une regex correcte pour valider les e-mails ?
Pas au sens où les gens l'entendent. Une regex qui implémente la RFC 5322 existe, mais elle compte des centaines, voire des milliers de caractères, accepte des formes exotiques dont vous ne voudriez jamais, et ne peut toujours pas confirmer que l'adresse est délivrable. En pratique, un motif court et permissif (ou le champ HTML5 type="email") pour attraper les fautes de frappe est la juste dose de regex - le reste est un problème de DNS et de SMTP.
02Pourquoi ma regex rejette-t-elle des adresses e-mail valides ?
Parce que les motifs stricts intègrent des hypothèses que les vraies adresses contredisent, comme des domaines de premier niveau de deux à quatre lettres (.photography en compte onze) ou l'absence de signe plus dans la partie locale. Une regex trop stricte est une cause fréquente d'inscriptions perdues. Restez permissif sur la syntaxe et vérifiez la délivrabilité séparément.
03Quelle est la longueur maximale d'une adresse e-mail ?
254 caractères. La RFC 5321 plafonne la partie avant le @ à 64 caractères et le domaine à 255, et limite le chemin SMTP complet à 256, chevrons autour de l'adresse compris. Une fois ces deux chevrons retirés, il reste 254 caractères pour l'adresse elle-même. Les contrôles qui acceptent jusqu'à 320 (64 + 1 + 255) sont plus larges, mais sans danger.
04La validation HTML5 des e-mails vérifie-t-elle si l'adresse est réelle ?
Non. La validation type="email" du navigateur est un contrôle de syntaxe - une version plus conviviale et normalisée de la même recherche de motif. Elle attrape les @ manquants et les malformations évidentes au niveau du champ, mais elle ne contacte jamais le serveur de messagerie ; elle ne peut donc pas vous dire si le domaine ou la boîte aux lettres existe.
05Que devrais-je utiliser à la place d'une regex pour valider les e-mails ?
Procédez par couches : un contrôle de syntaxe permissif pour un retour instantané, une résolution DNS/MX pour écarter les domaines morts, et une sonde SMTP de la boîte aux lettres pour confirmer la délivrance. Construisez vous-même les deux premières ; utilisez une API de vérification pour la couche SMTP, car la réaliser de façon fiable exige une réputation d'IP d'envoi et une limitation de débit qu'une regex ne pourrait jamais fournir.
Vous voulez voir la différence entre « syntaxe valide » et « livrera réellement » ?
Le forfait gratuit inclut 100 crédits de vérification qui exécutent
tout l'enchaînement — syntaxe, DNS et sonde SMTP de la boîte aux lettres — pour
que vous puissiez voir une adresse approuvée par une regex revenir
undeliverable.
Sans compte, collez typo@gmial.com dans le
vérificateur d'e-mails gratuit : toutes les regex de
cette page l'acceptent, et le vérificateur suggère gmail.com.
La référence de l'API propose des exemples à
copier-coller dans sept langages.