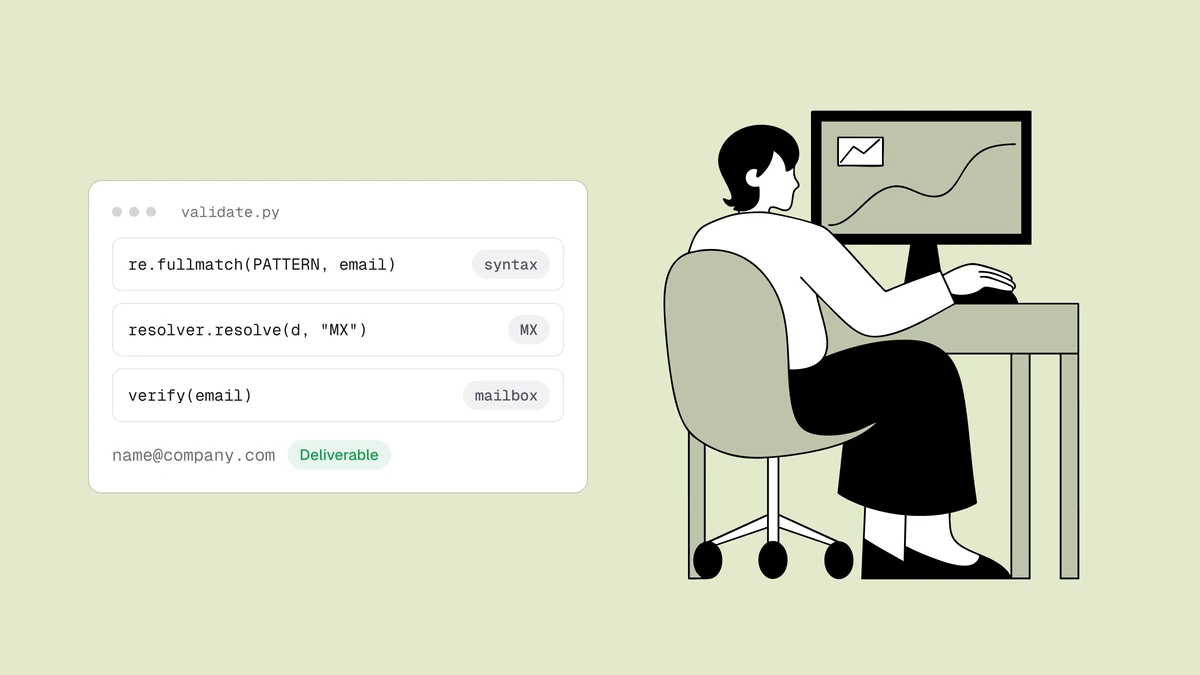
Pythonでメールアドレスを検証するには、3種類のチェックが必要です。多くのチュートリアルが紹介する正規表現は、そのうち最も役に立たないものです。実用的な検証は層になっています。構文チェック、DNSルックアップ、SMTPによるメールボックスの確認の順です。前の2つはPythonの標準ライブラリと小さな依存ライブラリ1つで対応できますが、3つ目はネットワークの問題であり、外部に任せる価値があります。このガイドでは、動作するコードで各層を組み立てます。
結論から#
構文チェックには緩めの正規表現(またはemail.utils.parseaddr)、MXの検索にはdnspython、SMTPによるメールボックスの確認には検証APIを使います。コストの低いものから順に実行し、結論が出た時点で打ち切ります。アプリからメールボックスを確認するためにsmtplibを使うのは避けてください。多くのホストでアウトバウンドのポート25がブロックされており、結果は送信元IPのレピュテーションやグレーリスティングに左右されます。これを自前で再実装するのは得策ではありません。
レイヤー1:構文#
構文チェックは緩めにします。目的は入力ミスの検出であり、RFC 5322を再実装することではありません(再実装しても役に立ちません)。
import re

SYNTAX = re.compile(r'^[^\s@."]+(?:\.[^\s@."]+)*@[^\s@.]+(?:\.[^\s@.]+)+$')

def is_valid_syntax(email: str) -> bool:
    return isinstance(email, str) and len(email) <= 320 and SYNTAX.match(email) is not None
is_valid_syntax("jane@example.com")  # True
is_valid_syntax("not-an-email")      # False
is_valid_syntax("a@@b.com")          # False
is_valid_syntax("a..b@x.com")        # False
標準ライブラリのemail.utils.parseaddrはアドレスを解析できますが、仕様上かなり寛容です。たとえばparseaddr("nonsense")は例外を出さずに('', 'nonsense')を返します。つまり、これは検証ツールではなくパーサーです。可否だけを判定する構文チェックには、短い正規表現のほうが分かりやすく向いています。
レイヤー2:そのドメインはメールを受信できるか#
MXレコードがないドメインは、誰宛てのメールも受け付けられません。dnspythonを使えば、MXレコードを数行で解決できます。
import dns.resolver  # pip install dnspython

def has_mail_route(domain: str) -> bool:
    try:
        answers = dns.resolver.resolve(domain, "MX")
        return len(answers) > 0
    except (dns.resolver.NXDOMAIN, dns.resolver.NoAnswer, dns.resolver.NoNameservers):
        return False
has_mail_route("gmail.com")              # True
has_mail_route("company-that-folded.com")  # False
このルックアップを1回行うだけで、無効なドメインや架空のTLDを無料で除外できます。MXがなくAレコードでメールを受け付けるドメインも有効として扱いたい場合は、MXの結果が空のときにA/AAAAを解決するフォールバックを加えてください。ただし、実在するアドレスの大半はMXチェックでカバーできます。
レイヤー3:メールボックスは本当に存在するか#
レイヤー1とレイヤー2でできるのは、アドレスを除外することだけです。メールボックスの存在を確認するには、SMTPの配信時のやり取りが必要です。smtplibでもそのやり取りを開始できますが、アプリケーションから実行するのはおすすめしません。ポート25は広くブロックされており、結果は接続元IPのレピュテーションに左右され、受信側は見知らぬ送信元に対してグレーリスティングやレート制限をかけます。この層は外部に任せましょう。
QualisendのPOST /verifyは、パイプライン全体を実行します。ローカルのチェックはすぐに結果を返し、SMTPプローブはキューに入ります。
import os
import requests  # pip install requests

BASE = "https://app.qualisend.com/api/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['QUALISEND_API_KEY']}"}

def verify(email: str) -> dict:
    res = requests.post(f"{BASE}/verify", headers=HEADERS, json={"email": email}, timeout=10)
    res.raise_for_status()
    return res.json()
サインアップ時のリアルタイム検証であれば、即座に返るresultだけで判断できることがほとんどです。SMTPで確認された結果が必要な場合は、まずresult["smtp"]を確認します。cachedまたはskippedなら結果はすでに確定しており、ジョブのポーリングが必要なのはpendingのときだけです。このポーリングは、リクエストの中ではなくバックグラウンドタスクで実行してください。
import time

def verify_and_wait(email: str, tries: int = 10, delay: float = 1.5):
    data = verify(email)
    if data["result"]["smtp"] != "pending":
        return data["result"]  # cached or skipped: already final
    job_id = data["job_id"]
    for _ in range(tries):
        res = requests.get(f"{BASE}/jobs/{job_id}",
                           params={"include": "results"}, headers=HEADERS, timeout=10)
        job = res.json()
        if job["status"] == "completed":
            return job["results"][0]  # {"status": ..., "score": ..., "reason": ...}
        if job["status"] in ("canceled", "failed"):
            return None
        time.sleep(delay)
    return None  # still processing — treat as unknown, retry later
リストを一括で検証する#
CSVの各行に対してverify()を1件ずつループで呼び出すのはやめましょう。行ごとにHTTPの往復とジョブが1つずつ発生します。リスト全体を1回のリクエストで/verify/bulkにPOSTするとjob_idが1つ返るので、バッチ全体を1回のポーリングで追跡できます。重複した行は除外され(クレジットも返金されます)、結果は最大1,000件ずつのページで返ります。ページを順に取得し、各行をemailをキーにして格納してください。
def verify_bulk(emails: list[str], tries: int = 60, delay: float = 2.0):
    res = requests.post(f"{BASE}/verify/bulk", headers=HEADERS,
                        json={"text": "\n".join(emails), "expected_count": len(emails)},
                        timeout=30)
    res.raise_for_status()
    job_id = res.json()["job_id"]

    for _ in range(tries):
        job = requests.get(f"{BASE}/jobs/{job_id}", headers=HEADERS, timeout=30).json()
        if job["status"] == "completed":
            return fetch_results(job_id)
        if job["status"] in ("canceled", "failed"):
            return None
        time.sleep(delay)  # back off; large lists take longer than a single probe
    return None

def fetch_results(job_id: str, page_size: int = 1000) -> dict:
    results, offset = {}, 0
    while True:
        page = requests.get(f"{BASE}/jobs/{job_id}", headers=HEADERS, timeout=30,
                            params={"include": "results", "limit": page_size,
                                    "offset": offset}).json()["results"]
        results.update({row["email"]: row for row in page})
        if len(page) < page_size:
            return results
        offset += page_size
数千件のバッチでは、SMTPプローブが1件ずつ別々のネットワーク通信になるため、完了まで数分かかることがあります。大きなリストでは、ポーリングエンドポイントを連打せず、triesとdelayを大きくしてください。クレジットを使う前に、2つのローカル層を実行して明らかな不正アドレスを除外してください。is_valid_syntaxとhas_mail_routeで絞り込み、残ったものだけを送信します。
asyncioとpydanticについて#
requestsはブロッキング処理です。そのためasyncioを使うアプリでは、呼び出しをasyncio.to_thread(verify, email)でラップするか、httpx.AsyncClientに切り替えて、複数の検証を並行して実行します。dnspythonにも同じ目的で非同期リゾルバー(dns.asyncresolver)が用意されています。すでにpydanticを使っている場合、EmailStr型はレイヤー1の置き換えとして手軽です。モデルの生成時に構文を検証してくれます。ただし、できるのはそこまでです。DNSにもメールボックスにも問い合わせないため、MXチェックと検証APIはその後段に残してください。
各層を組み合わせる#
コストの低いものから順に実行し、答えが出た時点で止めます。
def validate_email(email: str) -> dict:
    if not is_valid_syntax(email):
        return {"status": "undeliverable", "reason": "invalid_email"}
    domain = email.rsplit("@", 1)[1]
    if not has_mail_route(domain):
        return {"status": "undeliverable", "reason": "invalid_domain"}
    try:
        return verify(email)["result"]  # deliverable | risky | undeliverable | unknown
    except requests.RequestException:  # timeout, 402, 429, 5xx: fail open
        return {"status": "unknown", "reason": None}  # let it through, re-verify later
API呼び出し自体が失敗した場合(タイムアウト、クレジット不足の402、レート制限の429、5xxなど)、この関数はunknownを返して処理を通します(フェイルオープン)。サインアップはそのまま通し、あとでアドレスを再検証してください。
2つのローカル層はコストがかからず、不正アドレスの大半をその場で除外できます。APIを呼び出すのは、通信する価値のあるアドレスだけです。この順序になっている理由は、メールアドレス検証の仕組みで解説しています。
よくある質問
01Pythonの標準ライブラリだけでメールアドレスを検証できますか?
ある程度までは可能です。構文はreで確認でき、socketを使えばDNSの問い合わせも試せます。ただし、MXリゾルバーは標準では用意されておらず(そのためdnspythonを使います)、メールボックスの確認にはアプリから実行すべきではないSMTPプローブが必要です。標準ライブラリで対応できるのは構文と大まかなドメインチェックまでで、メールボックスの層にはdnspythonと検証サービスが必要です。
02メールボックスの存在確認にsmtplibを使わないのはなぜですか?
smtplibでもSMTPのやり取りは開始できますが、アプリケーションサーバーから実行すると不安定でリスクもあります。多くのホストがアウトバウンドのポート25をブロックしており、応答は送信元IPのレピュテーションに左右され、大量にプローブするとレート制限を受けたりブラックリストに載ったりします。検証APIなら、そのために作られたレピュテーション管理済みのインフラからプローブを実行します。
03MXの検索にはdnspythonが適していますか?
はい。PythonのDNSツールキットとして標準的で、保守も行き届いており、MXレコードをすっきり解決できます。pip install dnspythonでインストールし、NXDOMAIN、NoAnswer、NoNameserversを捕捉して、メールの経路がない場合は配信不能として扱います。
04pydanticのEmailStrでメールアドレスを完全に検証できますか?
いいえ。EmailStr(email-validatorパッケージが基盤)が行うのは、モデルの生成時に文字列が構文的に有効なアドレスかを確認することだけです。ドメインにMXレコードがあるかや、メールボックスが存在するかは確認しないため、レイヤー1にあたります。pydanticモデルの構文チェックとして使い、通過したアドレスに対してDNSルックアップと検証APIを実行してください。アドレスの正規化(ドメインの小文字化)も行うので、リストの重複排除の前処理にも便利です。
SMTPの層を追加する準備はできましたか?無料プランには100クレジットが含まれており、パイプライン全体を試せます。APIリファレンスでは、/verifyと/jobsのエンドポイントを、コピーして使える7言語のコード例とともに確認できます。