どのコードベースにも1つはあります。Stack Overflowからコピーした、アドレスを「検証」するメール用の正規表現です。チェックしているように見えますが、答えているのは、ほとんど誰も本当には尋ねていない問いです。正規表現が教えてくれるのは、文字列がメールアドレスの形をしていることだけです。そのアドレスが実在するか、メールを受け付けるか、次のキャンペーンでハードバウンスしないかは分かりません。そして重要なのは、まさにその点だけです。
結論から#
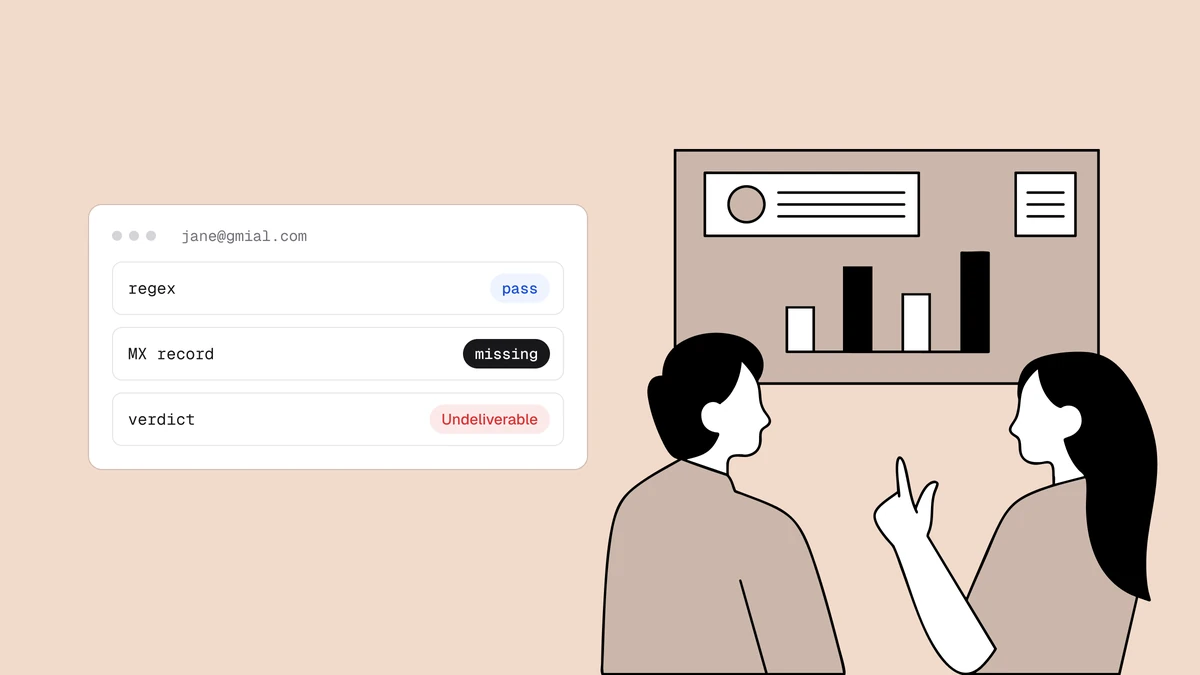
正規表現が検証するのは構文であり、到達可能性ではありません。definitely-fake@gmail.comは、これまでに書かれたどの正規表現でも完全に有効なメールアドレスですが、送信した瞬間にバウンスします。さらに悪いことに、よく使われる正規表現は、実在するアドレスを拒否する(厳しすぎる)か、無意味な文字列を通してしまう(緩すぎる)かのどちらかです。技術的に正しい正規表現は数百から数千文字に及びますが、それでもメールボックスの存在は確認できません。入力欄では、打ち間違いを防ぐ簡単な構文チェックを使い、到達可能性はDNSとSMTPのチェックで検証してください。これはパターンマッチの問題ではなく、ネットワークの問題です。
よく見る正規表現と、通してしまうアドレス#
典型的な例を示します。多くのプロジェクトに、これに近いものがあります。
const re = /^[^@\s]+@[^@\s]+\.[^@\s]+$/;
re.test("definitely-fake@gmail.com"); // true  ← will hard-bounce
re.test("typo@gmial.com");            // true  ← typo'd domain, bounces
re.test("info@company-that-folded.com"); // true  ← dead domain
3つとも通過しますが、3つとも配信できません。正規表現は役目を完璧に果たしたものの、有用なことは何も分かりませんでした。構文と到達可能性は別の問いだからです。正規表現から見えるアドレスはすべて文字列にすぎず、その宛先で人間がメールを読んでいるかどうかは、文字列ではなくインターネット上の事実です。
gmial.comのようなドメインの入力ミスは、どんなパターンでも検出できません。既知のプロバイダーとの比較が必要です。よくあるメールアドレスの入力ミスを参照するか、無料のメールアドレス入力ミスチェッカーをお試しください。
厳格な正規表現が誤って拒否するアドレス#
厳格なパターンは、逆の方向で失敗します。次の典型的な「より厳密な」パターンは、下の表のすべての有効なアドレスを拒否します。
const STRICT = /^[\w.-]+@\w+\.[a-z]{2,4}$/i;
| アドレス | 誤った前提 | 実際 |
|---|---|---|
jane+news@example.com | ローカル部は英字、数字、ドット、ハイフン、アンダースコアだけ | プラスアドレスは規格上有効です。Gmailをはじめ多くのサービスは、
+tag付きのメールを元のメールボックスに配信します |
o'brien@example.com | 名前に記号は含まれない | アポストロフィはローカル部で使用できる文字です |
jane@studio.photography | TLDは2~4文字 | .photographyのような長いTLDは、何年も前から使われています |
jane@mail.example.co.uk | ドメインは名前1つとTLDで構成される | .co.ukやメール用のサブドメインでラベルが増えます |
jane@my-company.com | ドメインは英字と数字だけ | ラベル内のハイフンは規格上有効です |
拒否されるたびに、実在の利用者がサインアップで締め出されています。それなのに、バウンスログには一切現れません。厳しすぎるパターンが何年も生き残るのはそのためです。後述の構文チェックは、この5つすべてを受け付けます。
RFC 5322という迷路#
「それなら正しい正規表現を使えばいい」と考える人もいるでしょう。メールアドレスの正式な文法はRFC 5322で定義されており、それを実際に実装した正規表現は、巨大なことで有名です。数百から数千文字に及び、受け付けたくないものまで許可してしまいます。たとえば、スペースを含む引用符付きのローカル部("a b"@example.com)や、アドレス内のコメントです。
ここから2つの問題が生じます。1つ目に、この厳密な正規表現は、アドレスを絞り込むどころか、望むより多く受け付けてしまいます。検証の基準は2008年の仕様であり、「実際のメールサーバーが配信するアドレス」ではないからです。2つ目に、RFC 5322に完全に一致したとしても、そのドメインにメールサーバーがあるか、メールボックスが存在するかは分かりません。やさしい問いにより高い精度で答えるために膨大な労力をかける一方で、難しい問い、つまり「メールは届くのか」には、まったく手が付けられないままです。
長さの上限:64、255、254#
SMTPの標準であるRFC 5321は、ローカル部(@の前)を64オクテット、ドメインを255オクテットに制限し、アドレスを囲む山括弧(<jane@example.com>)を含めたパス全体を256オクテットに制限しています。その結果、アドレス自体の実際の上限は254文字になります。
当社の言語別ガイドの一部では、代わりにlength <= 320(64 + 1 + 255)をチェックしています。緩めですが害はありません。拒否されるものは確かに長すぎますし、254文字を超えて通過したものも、DNSとSMTPのチェックを通る必要があります。
正規表現には根本的にできない3つのこと#
どれほど巧妙なパターンでも、ネットワークの向こう側には手が届きません。正規表現にできないことは次のとおりです。
- ドメインがメールを受信できるかの確認。
user@company-that-folded.comは、MXレコードのないドメインでも構文としては有効です。無効なドメインはDNSルックアップでしか分かりません。 - メールボックスの存在確認。
noreply-9f2x@gmail.comは、一度も作成されていないアカウントでも構文としては有効です。存在しないことは、GmailとのSMTPのやり取りでしか分かりません。 - キャッチオールドメインの検出。 キャッチオールサーバーはすべてのアドレスを受け付けるため、SMTPチェックを実際に行っても特定のメールボックスは確認できません。正規表現には、そのドメインがそう動作することが分かりません。
これらは特定の正規表現の欠陥ではなく、どんな正規表現にもできないことです。問われているのは文字列ではなくサーバーのことだからです。これに答えるのがメールアドレス検証の役割であり、文字列ではなくネットワークに問い合わせます。
実際にすべきこと:層に分けて検証する#
到達可能性の確認は、コストが段階的に高くなるチェックのパイプラインです。構文は、コストの低い最初の段階にすぎません(全体像はメールアドレス検証の仕組みで解説しています)。
- 構文:入力欄で行う、明らかな入力ミスを検出する簡単なチェックです。正規表現を使うのはこの層だけです。
- ドメインとMX:ドメインがそもそもメールを受信できるかを確認するDNSルックアップです。動作するコードは、Node.jsとPythonのガイドを参照してください。
- SMTPによるメールボックスの確認:メールボックスを実際に確認する配信時のやり取りで、キャッチオールの検出も含みます。これにはIPレピュテーションの良好なメールサーバーと、慎重なレート制限が必要です。そのため、多くのチームは自作せず検証APIを利用します。アドレスの所有者本人であることの確認は別の仕事であり、ダブルオプトインメールで行います。
残しておく価値のある構文チェック#
レイヤー1では、RFC 5322準拠のチェックを自作しないでください。現実的なのは、ブラウザーのHTML5メール入力(WHATWG Living Standardのパターンが無料で適用されます)と、サーバー側の短く緩めのチェックです。
// Pragmatic: rejects fat-finger errors, accepts the addresses real
// mail servers actually deliver to. Not a deliverability check.
const SYNTAX = /^[^\s@."]+(?:\.[^\s@."]+)*@[^\s@.]+(?:\.[^\s@.]+)+$/;

function isPlausibleEmail(email) {
  return (
    email.length <= 254 &&      // RFC 5321 path limit
    email.indexOf("@") <= 64 && // local part limit
    SYNTAX.test(email)
  );
}

isPlausibleEmail("jane@example.com");             // true
isPlausibleEmail("jane+news@mail.example.co.uk"); // true
isPlausibleEmail("not-an-email");                 // false
isPlausibleEmail("a@@b.com");                     // false
isPlausibleEmail("a..b@x.com");                   // false: consecutive dots
isPlausibleEmail(".a@x.com");                     // false: leading dot
isPlausibleEmail("a.@x.com");                     // false: trailing dot
これはキーボード入力時の即時フィードバックに使うもので、それ以上のものではありません。通過は「きちんと確認する価値がある」という意味であり、「有効」という意味では決してありません。
ドットはローカル部の文字クラスに含めていないため、文字と文字の間にしか置けません。これにより3種類のドットの誤りを拒否し、厳格な正規表現の表にある5つのアドレスをすべて受け付け、パターンの処理も高速に保てます。ブラウザーでのチェックは利便性のためのもので、関門ではありません。誰でもエンドポイントに直接POSTできるため、サーバー側でも同じチェックを繰り返してください。
ReDoS:メール用の正規表現が脆弱性になるとき#
形の悪いパターンは、サービスを停止させることもあります。JavaScriptやPythonの組み込みエンジンはバックトラックを行います。マッチに失敗すると、パターンが入力を分割できる他の方法をすべて試し直します。繰り返しのグループが、その直前の部分と同じ文字にマッチできる場合、分割の数は指数関数的に増えます。
このページの以前のバージョンでは、そうした形の[^\s@"]+(?:\.[^\s@"]+)*を推奨していました。ドットが文字クラスにもグループの区切りにも当てはまる形です。@のないa.の繰り返しの文字列では、Nodeで行った簡単なテストで、ドットが1つ増えるごとに処理時間がほぼ2倍になり、60文字未満の入力でプロセスが数秒間ブロックされました。これがReDoS(CWE-1333)です。以前のパターンをコピーした場合は、上記のものに置き換えてください。
対策は3つあります。
- 重ならない文字クラス。 ドットを文字クラスに含めなければ、どの入力も読み取り方が1通りになるため、上記のパターンは線形時間で動作します。
- 線形時間のエンジン。 Goの
regexpは線形時間を保証しており、RE2のバインディングを使えばNodeやPythonでも利用できます。 - パターンの代わりにパーサーを使う。 たとえばGoの
net/mail.ParseAddressです。Goは最新の状態に保ってください。1.24.8および1.25.2より前のリリースでは、非常に長いドメインリテラルの解析が遅くなります。
長さの上限を設けても防げません。この形では、254文字よりずっと短い入力でも処理が止まります。この欠陥があるか確かめるには、"a.".repeat(25) + "!"のようなマッチしない文字列の処理時間を測ります。脆弱なパターンでは体感できる程度(1秒足らず)の時間がかかり、安全なパターンなら即座に答えが返ります。
言語別の構文チェック#
ほとんどのスタックには構文チェックが付属しているため、自前のパターンが必要になることはまれです。各ガイドは3つの層をすべて扱っています。この表はレイヤー1だけを示します。
| スタック | 構文チェック |
|---|---|
| Node.js | 上記の正規表現 |
| Express | express-validatorのisEmail() |
| Next.js | zodのz.string().email() |
| Python | 上記の正規表現 |
| Django | validate_emailまたはEmailField |
| Flask | WTFormsのEmail() |
| PHP | filter_var()とFILTER_VALIDATE_EMAIL |
| Laravel | email:rfc,dns(構文とDNSによるメール経路のチェック) |
| Go | net/mail.ParseAddress |
| Java | Jakarta MailのInternetAddress |
| Spring Boot | Jakarta Bean Validationの@Email |
| C# | MailAddress.TryCreate |
| ASP.NET Core | [EmailAddress] |
| Ruby | URI::MailTo::EMAIL_REGEXP |
| Rails | formatとURI::MailTo::EMAIL_REGEXP |
組み込みのチェックは、表示名(Jane <jane@example.com>)のような境界ケースで挙動が異なります。各スタックの癖は、それぞれのガイドで解説しています。
残りの工程を進める#
構文チェックを通過したら、本当の検証はネットワークでの作業になります。DNSとSMTPの層は自分で構築することもでき、どこまでできるかは上記の言語別ガイドで確認できます。ただし、実在するメールボックスを大規模に確認するとなると、ほとんどのホストでブロックされているポート25、IPレピュテーション、グレーリスティングといった壁にぶつかります。マネージドAPIの出番はそこにあります。QualisendのPOST /verifyはパイプライン全体を実行し、理由コード付きの4段階の判定(deliverable | risky | undeliverable | unknown)を返します。そのため、コードは文字列に@があるかどうかではなく、メールボックスが存在するかどうかに基づいて動作できます。
よくある質問
01メール検証に使える正しい正規表現はありますか?
多くの人が期待する意味では、ありません。RFC 5322を実装した正規表現は存在しますが、数百から数千文字に及び、受け付けたくない特殊な形式まで許可してしまううえ、そのアドレスが配信可能かどうかは確認できません。実用上は、入力ミスを検出するための短く緩めのパターン(またはHTML5のtype="email"入力)が、正規表現として適切な範囲です。残りはDNSとSMTPの問題です。
02正規表現が有効なメールアドレスを拒否するのはなぜですか?
厳格なパターンには、実在のアドレスが当てはまらない前提が組み込まれているためです。たとえば、トップレベルドメインは2~4文字(.photographyは11文字です)、ローカル部にプラス記号は含まれない、といった前提です。厳しすぎる正規表現は、サインアップを取りこぼす一般的な原因です。構文チェックは緩めにし、到達可能性は別に検証してください。
03メールアドレスの最大長は何文字ですか?
254文字です。RFC 5321は、@の前の部分を64文字、ドメインを255文字に制限し、アドレスを囲む山括弧を含むSMTPのパス全体を256文字に制限しています。2つの山括弧を除くと、アドレス自体に残るのは254文字です。最大320文字(64 + 1 + 255)まで許可するチェックは緩めですが、害はありません。
04HTML5のメール検証は、アドレスが実在するかを確認しますか?
いいえ。ブラウザーのtype="email"による検証は構文チェックであり、同じパターンマッチを標準化して使いやすくしたものです。入力欄で@の欠落や明らかな形式の誤りは検出しますが、メールサーバーには一切接続しないため、ドメインやメールボックスが存在するかどうかは分かりません。
05メール検証に、正規表現の代わりに何を使うべきですか?
層に分けて検証します。即時フィードバックのための緩めの構文チェック、無効なドメインを除外するDNS/MXルックアップ、配信可否を確認するSMTPによるメールボックスの確認です。前の2つは自分で構築できます。SMTPの層には検証APIを利用してください。確実に行うには、正規表現では到底得られない送信元IPのレピュテーションとレート制限が必要になるためです。
「構文として有効」と「実際に配信される」の違いを確かめたいですか?無料プランには100クレジットが含まれており、構文、DNS、SMTPによるメールボックスの確認というパイプライン全体を実行できます。正規表現を通過したアドレスがundeliverableで返ってくる様子を確認できます。アカウントがなくても、typo@gmial.comを無料メールチェッカーに貼り付けてみてください。ここで紹介したどの正規表現もこれを受け付けますが、チェッカーはgmail.comを提案します。APIリファレンスには、コピーして使える7言語のコード例があります。